在網路上預訂租車,表單要填駕照號碼和到期日,駕照卻不在手邊。你記得去年換新駕照時拍過照片,正反兩面,可是它們混在 iPhone 裡幾萬張照片中間。你想用自然語言問 Comma,把這兩張照片找出來。
這篇指南介紹一種做法:先用本機模型替照片建立一份索引,再讓 Comma 去搜尋它。這是在一台 Mac 上的示例設定,不是 Comma 的內建功能。
圖庫留在本機
Comma 不需要你照片的副本。最費力的工作,也就是讀出每張圖裡的文字、把每張照片轉成向量,都由本機模型完成。AI 代理拿到的是一次搜尋的結果:幾個照片 ID、它們的日期、圖裡辨識出的文字,以及需要你挑選時的一張縮圖拼圖。只有你最後挑中的照片,才會傳到對話裡。
照片同步本身走 iCloud;這裡說的本機,指的是匯出之後的辨識、向量和索引。如果 Comma 用的是雲端模型,這些搜尋結果,以及你讓它查看的圖片,會傳給你選擇的模型供應商;像駕照這樣的證件,辨識出的文字裡就有號碼和住址。索引本身不會傳到任何地方。Comma 本身是開源的,也可以部署在你自己的機器上。
建立照片索引
索引接在照片原本就會走的路徑後面,iPhone 上什麼都不用改。
設定分三步:
把照片匯到本機。 用 iCloud 照片把 iPhone 上的照片同步到 Mac,每天把新照片匯出到一個資料夾。
用本機模型處理。 辨識圖裡的文字,再用 Chinese-CLIP 和 Qwen3-VL-Embedding 把畫面轉成向量。
存進本機索引。 結果存進本機資料庫,再配一條搜尋指令。範例裡這個指令叫
lpa。
搜尋會傳回什麼
在本機,一次搜尋就是一條指令。一次呼叫可以放進幾種說法,模型只載入一次;AI 代理會把「去年」這樣的說法換成一段日期範圍。
每筆結果都會標出它背後是哪種依據:
--prefer text 把文字命中排在前面,適合找證件、卡片和螢幕截圖。--prefer picture 把畫面相似的排在前面,適合找貓或海灘。幾分鐘內拍下、幾乎一樣的照片在清單裡只佔一個位置,其餘的附在它下面。
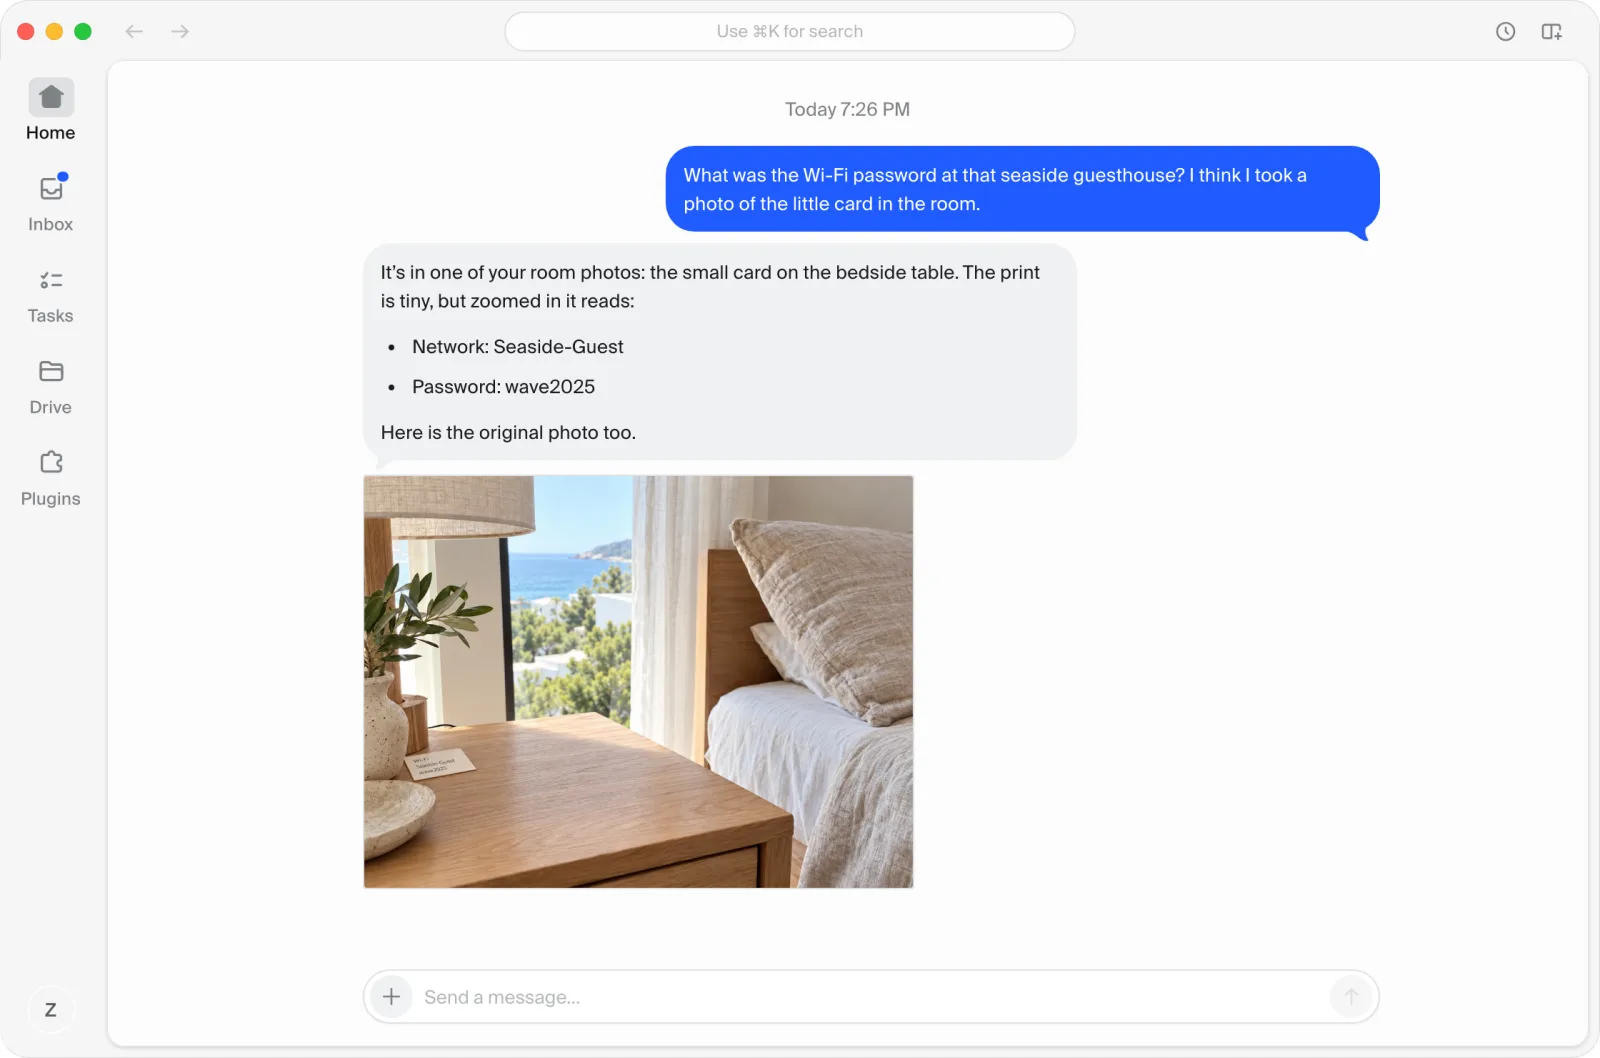
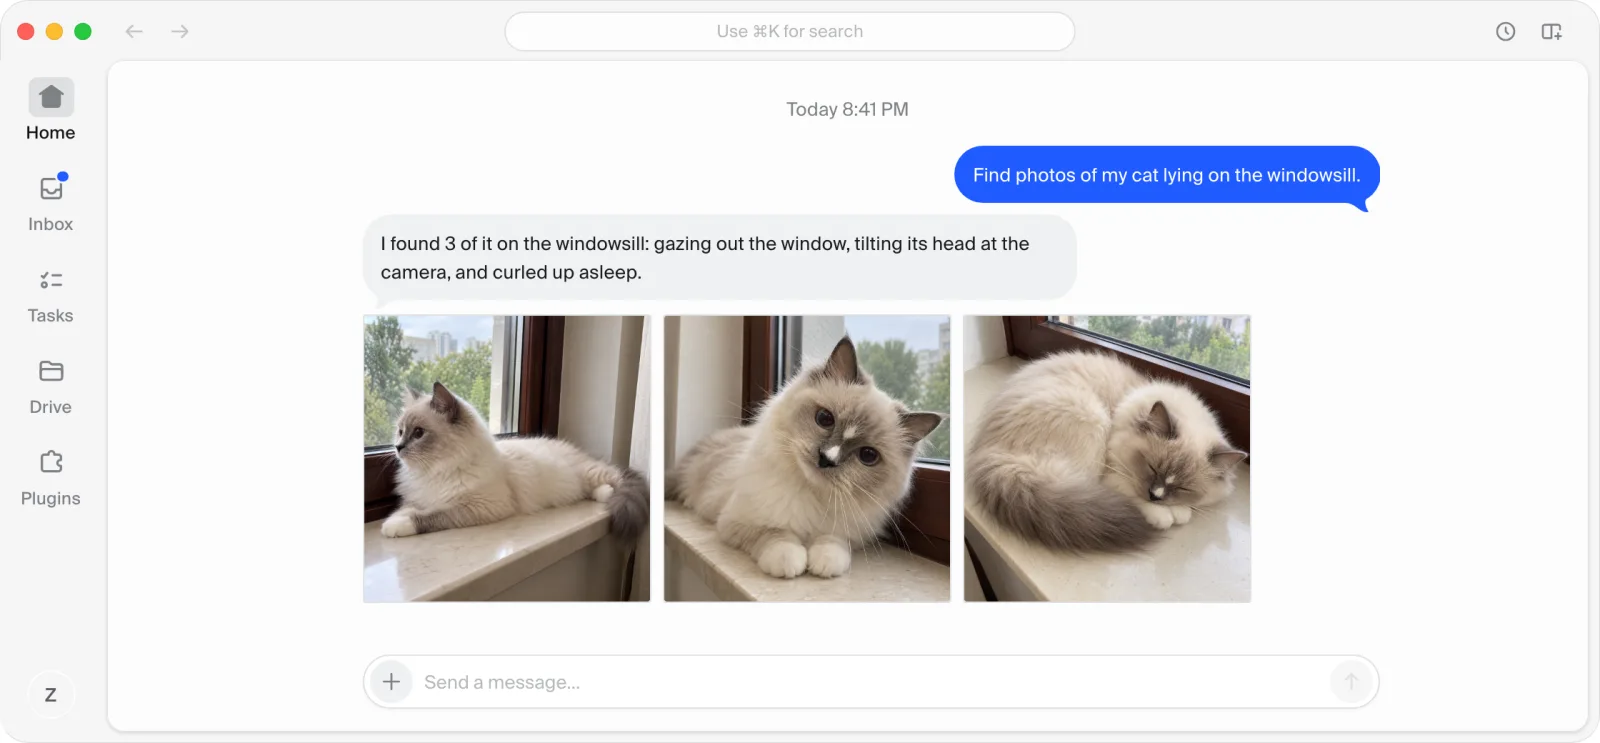
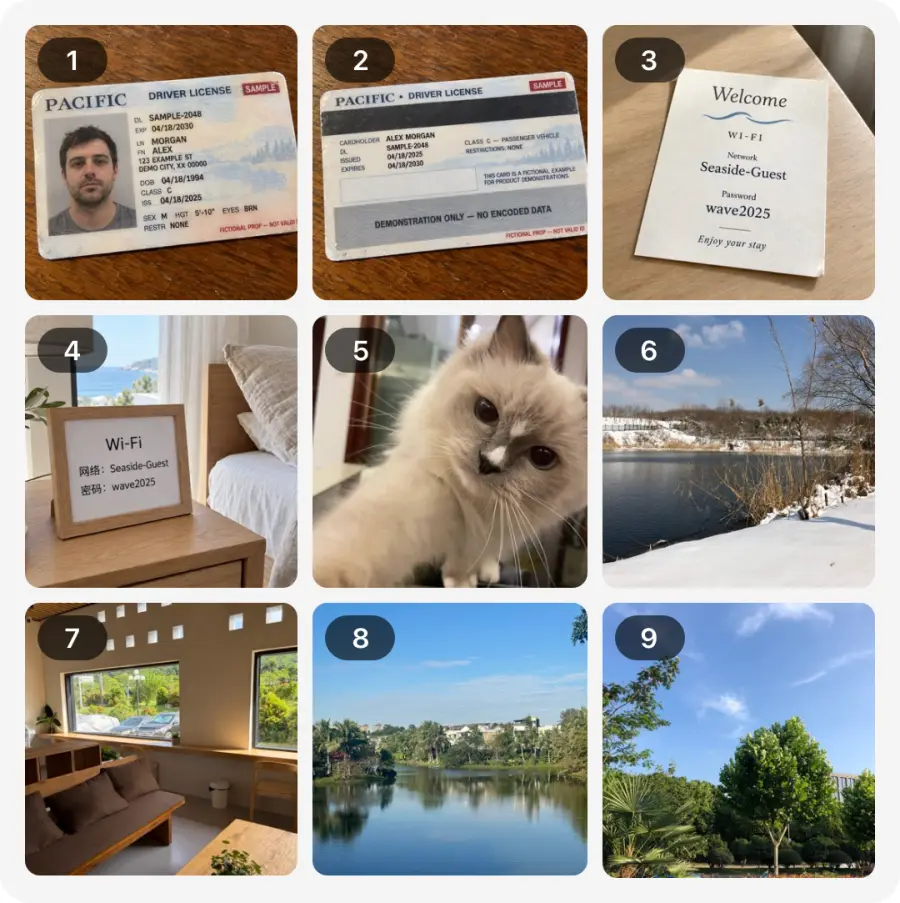
排在最前面的結果不確定時,AI 代理不會去猜。它會把候選的縮圖拼成一張帶編號的圖,最多九張,請你來挑。
兩組向量的用法,是在約 5 萬張照片的完整圖庫上校準後定下的。單用 Qwen3-VL-Embedding 時,人工挑出的正確答案反而比單用 Chinese-CLIP 排得靠後;兩份排名合併後,檢查過的每一項都不比單用任何一個模型差。「可能」也要兩個模型的相似度都過門檻才會標上,在一次測試查詢裡,標成「可能」的照片從 4,970 張降到 4 張。代價是一次搜尋從約 3 秒變成 3.5–6 秒。
這套範例在一台 16 GB 記憶體的 MacBook Air 上執行,Qwen3-VL-Embedding 用的是 2B。機器更好的話,可以換更大的 Qwen 模型:
更大的向量模型。 把 Qwen3-VL-Embedding-2B 換成 Qwen3-VL-Embedding-8B。換了以後,所有照片的向量都要用新模型重算一遍。
替照片寫描述和標籤。 另外執行 Qwen3-VL-4B-Instruct 或 Qwen3-VL-8B-Instruct,替每張照片寫一句描述、列幾個標籤,存進文字索引。例如在一台 24 GB 記憶體的 MacBook Pro 上,8B(8-bit 量化)就能執行。產生的標籤適合粗篩,不保證準確。
英文怎麼辦? Chinese-CLIP 主要用中文圖文訓練,英文查詢它不可靠。另外兩項不受影響:文字辨識中英文都認得,Qwen3-VL-Embedding 也支援多種語言。所以搜尋時中英文說法一起放,就像前面那條指令,這一點可以寫進 Skill。圖庫和提問以英文為主的話,也可以把 Chinese-CLIP 換成原版的 CLIP,換了同樣要重算向量。
找家人和朋友
「照片」本來就會把同一個人的臉歸在一起。索引直接用這份分組,自己不做人臉辨識。
先認人。 第一次使用時,AI 代理從這些分組裡挑出幾批照片,編上號問你這是誰。你回一句「3 號是媽媽」,它才記下。沒確認過的分組,不會被當成任何人。
按人找。 之後提到名字,搜尋只在這個人出現的照片裡找。名字可以疊加:說兩個人,就只傳回兩個人都在的照片,也就是你們的合照。
和其他條件一起用。 人名可以和畫面、時間一起搜尋,例如「去年我和媽媽在海邊的合照」:
名字沒確認過,或者有兩個人同名,搜尋會直接說明,不會猜。認錯了可以改,每次修改都能復原。
影片怎麼找
影片和照片分開搜尋。預設的搜尋只查照片;例如你想找孩子生日吹蠟燭的那段影片,跟 Comma 說清楚要找影片,它會在搜尋裡加上 --source video:
背後分三步:
擷取畫面。 影片本身不進模型。索引程式每 5 秒從影片裡擷取一格,每段最多 12 格。
按畫面搜尋。 擷取下來的畫面和照片走同樣的處理:辨識文字、算兩組向量。搜尋比對的是這些畫面,哪一格對上了,整段影片就算找到,在結果裡只佔一筆。
傳送影片。 你選定以後,AI 代理用
lpa video把影片傳過來。
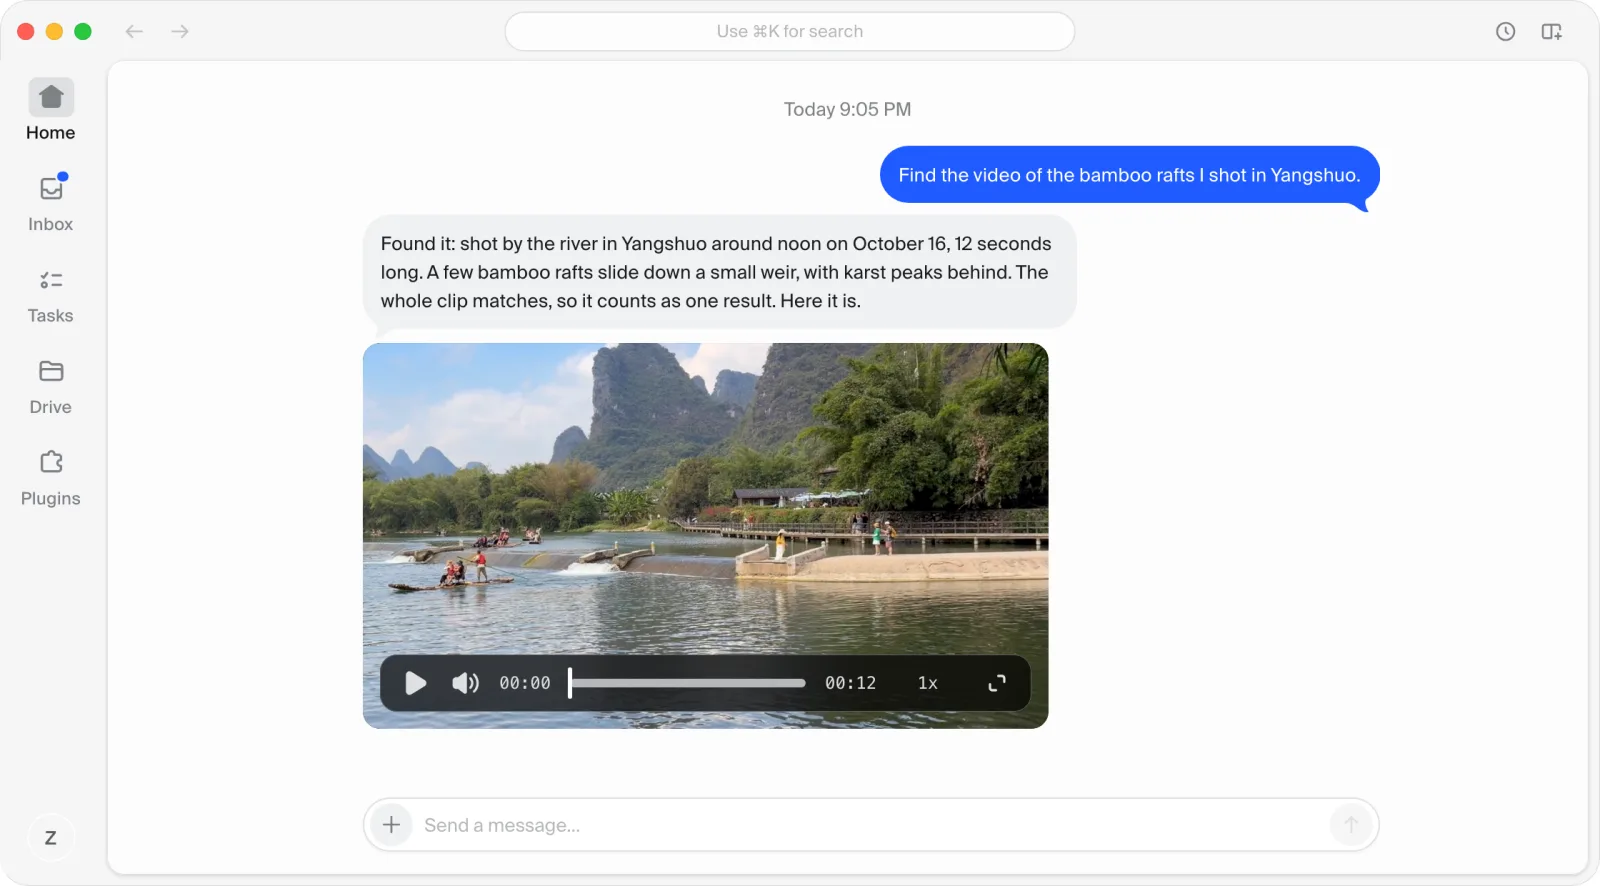
目前只看畫面,不聽聲音,影片裡說過的話還搜不到,影片裡的人也還認不出來。擷取的格數有上限,長影片裡一閃而過的畫面可能找不到。
LocalPhotoAgent 的結構
文中的 lpa 來自我們自己寫的索引程式 LocalPhotoAgent,之後會開源。建立索引的部分前面已經講過,這裡補充兩點:
可以隨時停下。 每張照片的每一步都單獨記錄,執行到一半停下,下次接著做;改了某項設定,只重跑受影響的那一步。處理時會盯著記憶體、溫度和磁碟空間,超過就先停下。
給 AI 代理幾條指令。
lpa search搜尋,lpa sheet產生拼圖,lpa preview傳照片,lpa video傳影片。AI 代理查照片時按這個順序呼叫:
連接 Comma
前提是 LocalPhotoAgent 已經在 Mac 上順利執行。連接分四步:
新增裝置。 在 Comma 的 Settings > Devices 裡點 Add device,取得一條安裝指令。
執行指令。 在放圖庫的那台 Mac 的「終端機」裡執行它,裝上 Comma Connector。
開啟權限。 新裝置預設是 Off,改成 Full,AI 代理才能執行
lpa。寫一個 Skill。 告訴 AI 代理先搜尋、不確定時傳拼圖、你挑完再傳照片。可以直接請 Comma「建立一個 Skill」。
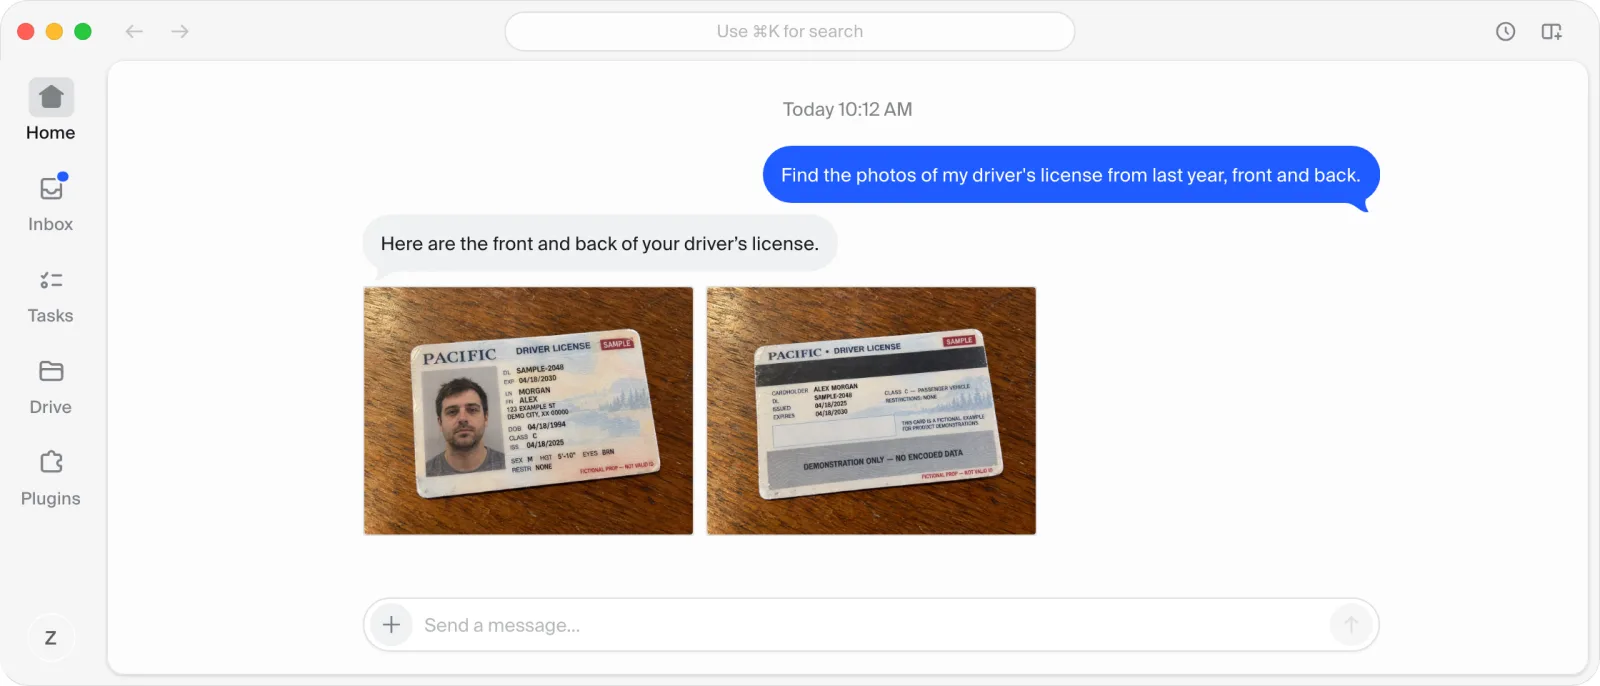
之後就和平常聊天一樣,直接問:「找一下我去年拍的駕照,正反兩面都要。」
信任與限制
索引只讀取原圖,從不移動、編輯或刪除它們。搜尋完全不碰外接硬碟;只有產生拼圖或傳送照片時才會讀它。移動或刪除照片不在這套設定的範圍內;不過設成 Full 權限後,AI 代理能在這台 Mac 上執行的指令不只限於 lpa。
文字命中只說明找到了這些字,不代表就是你想要的那張照片。「可能」只是候選。Comma 把請求標為已完成時,請檢查它傳來的照片。
第一次試的時候,你可以這樣說:「找出我去年拍的駕照照片。先給我看拼圖,不要傳送、移動或刪除任何東西。」